Local Factory
Un atelier logiciel qui tourne sur un GPU local : une spécification entre, un diff sort, les tests tranchent, sans appeler le moindre service en ligne.
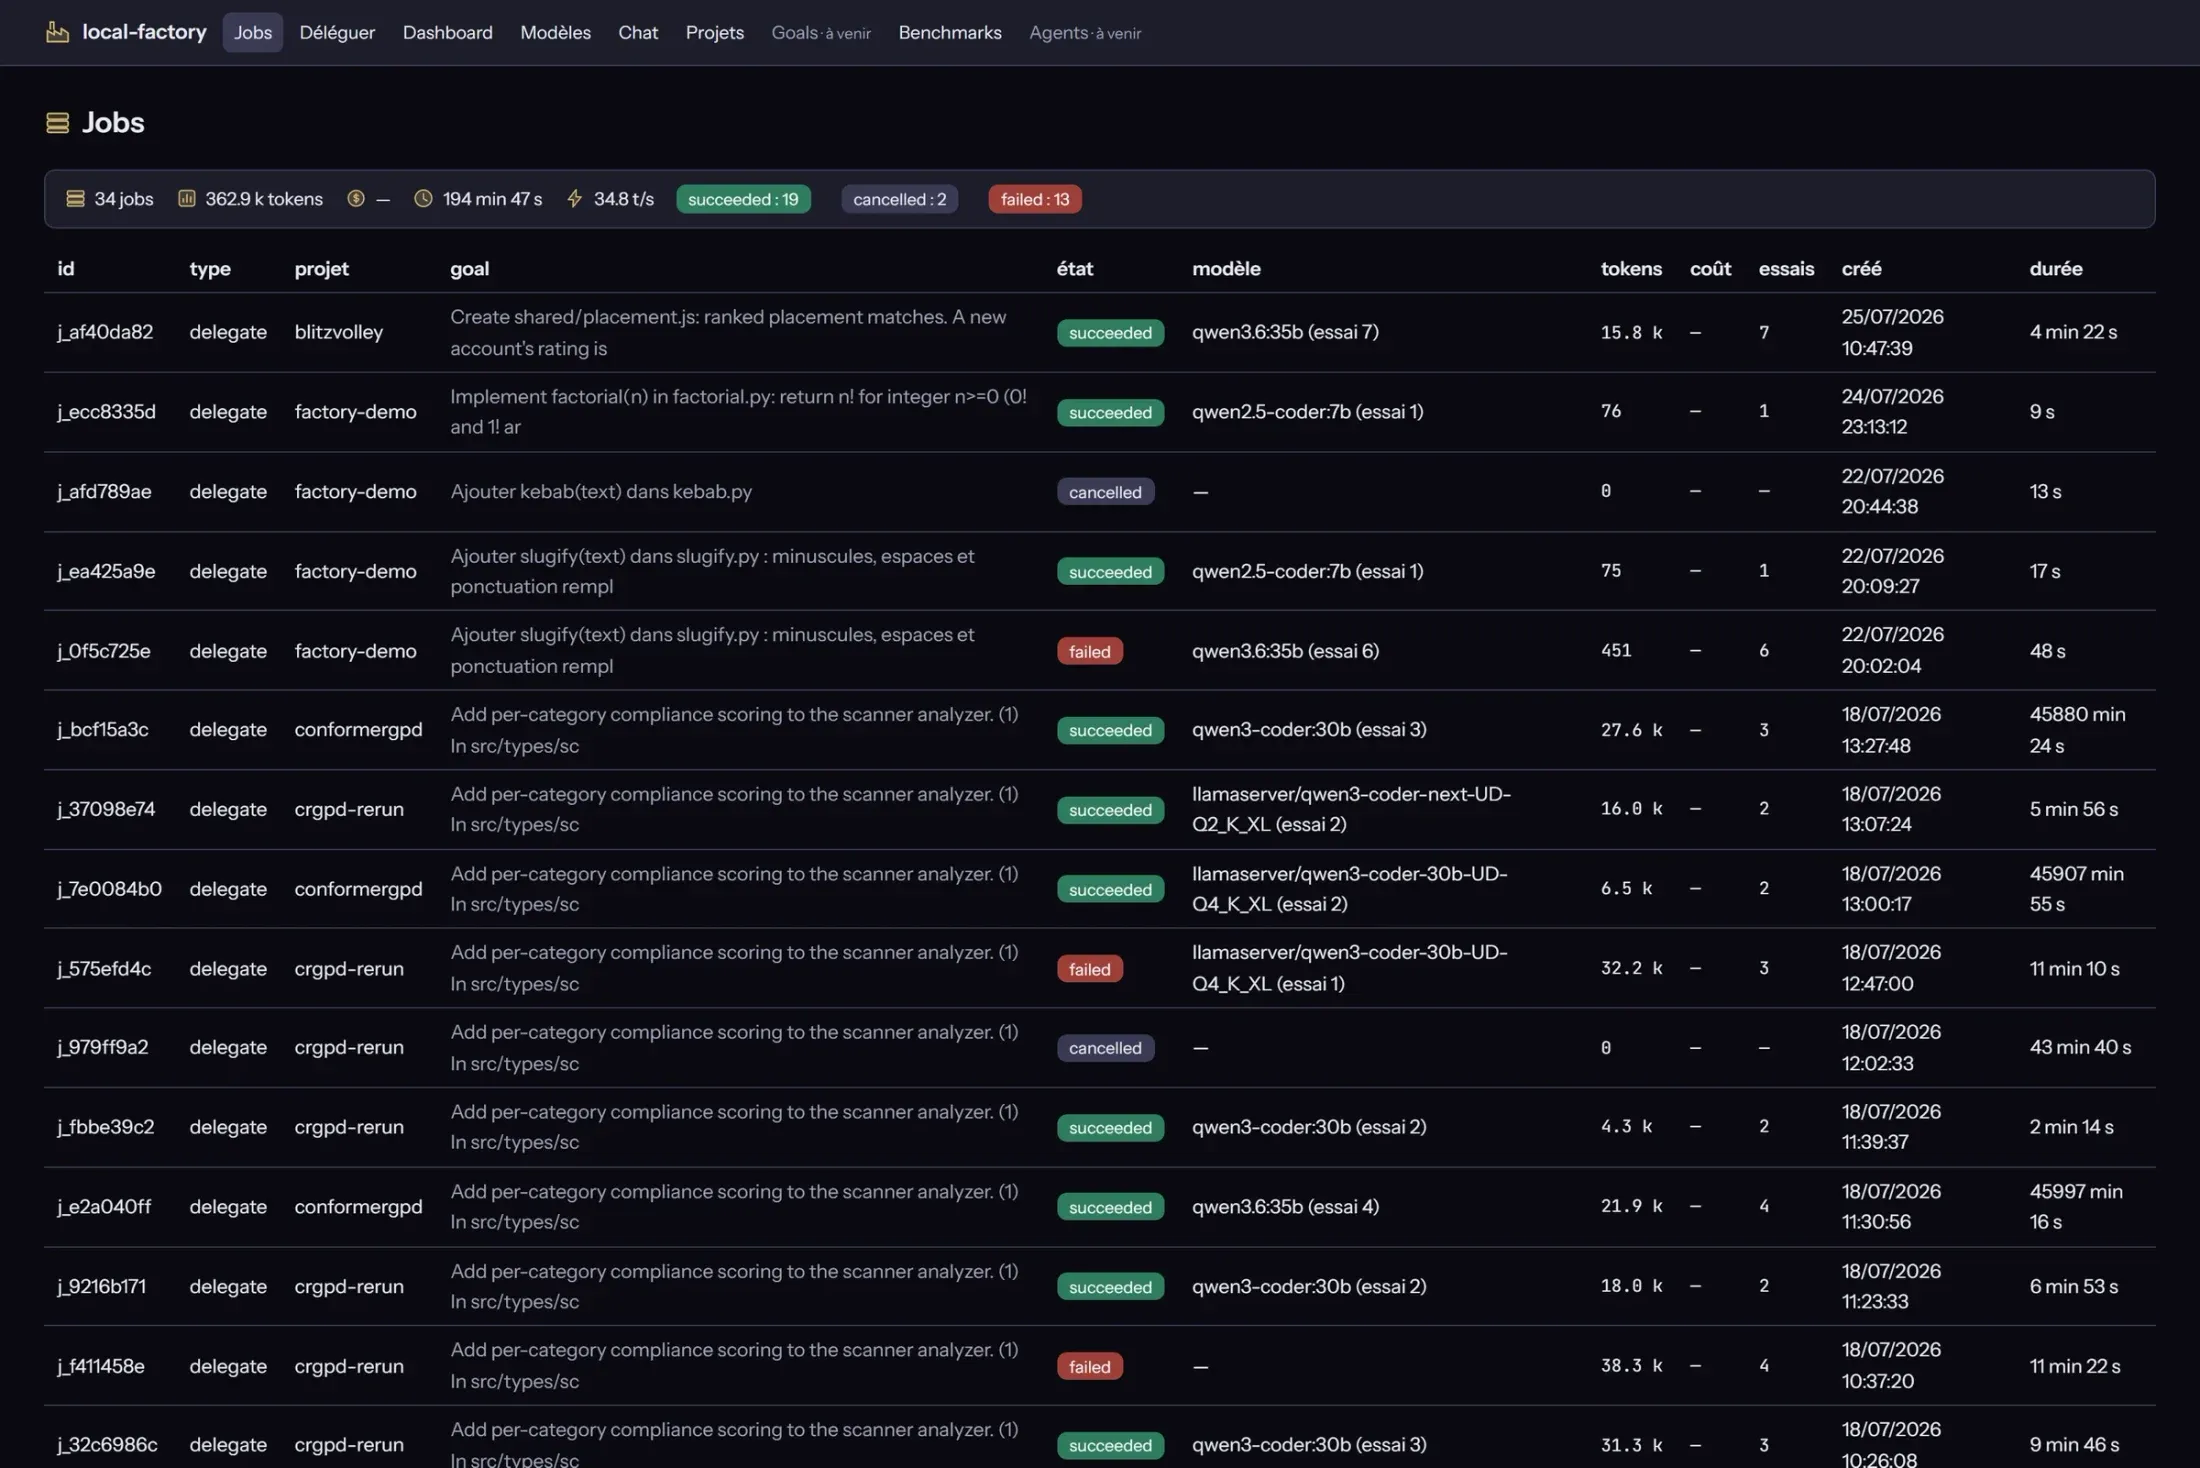
Un harnais qui fait travailler des modèles ouverts installés en local. Une tâche descend une échelle de modèles : le plus petit essaie d’abord, seuls les échecs remontent d’un cran. Chaque tentative est confrontée à une spécification et à une suite de tests avant qu’un relecteur automatique l’accepte ou la rejette.
Autour du harnais, quelques essais plus petits ont servi de bancs d’essai. Un agent qui réécrit
son propre code en suivant des métriques calculées sur l’arbre syntaxique (self-improving-AI) ;
un orchestrateur d’agent doté d’une mémoire de projet, resté à l’ébauche (GPT_code) ; une
batterie de tâches de code et de logique pour comparer les modèles locaux (local-LLM) ; des
rôles d’équipe, chef de produit, développeur et architecte, définis comme modèles Ollama
(quiz-app) ; et un petit projet Python qui servait de cible aux premières tentatives
(factory-demo).
Ce qui compte ici n’est pas la démonstration mais la mesure. Le projet tient un registre des optimisations où les idées sont marquées falsifiée quand les chiffres le disent : deux d’entre elles le sont, et elles y restent. Une autre fois, le harnais annonçait cinq étapes réussies sur cinq devant un diff vide, ce qui a révélé trois défauts distincts, tous penchant du même côté, celui de l’agent.
La même erreur s’est produite dans l’autre sens, côté humain. Un modèle de trente-cinq milliards de paramètres semblait avoir atteint une limite de raisonnement ; la cause réelle était une longueur de contexte mal réglée. Depuis, la règle est en tête des instructions du projet : ne jamais conclure sur un échec sans autopsie. Plus tard, un banc d’essai par palier a fait tomber une conviction tenue depuis des semaines, celle que le gros modèle ne servait qu’en escalade. Deux bugs du harnais faussaient tous les verdicts enregistrés. Corrigés, le palier supposé réservé à l’escalade est devenu le meilleur, et la conviction précédente est partie au registre marquée falsifiée, pas supprimée.
Les garde-fous sont exécutables plutôt qu’écrits sur un mur, et cette règle-là est une
cicatrice : un agent a lancé un git stash et effacé des modifications en cours. La réponse n’a
pas été de mieux écrire la consigne, puisqu’une consigne se contourne, mais de la rendre
inapplicable : git stash, reset --hard, push --force et toute suppression sous .git/
sont refusés au niveau de l’outil, pas du prompt. À quoi s’ajoutent les deux règles qui
protègent le dépôt plutôt que le travail en cours : pas de livraison sur la branche principale,
pas de poussée tant que les tests sont rouges.
La conclusion, après tout cela, n’est pas confortable : la limite n’est pas le harnais, elle est dans les modèles qu’une machine personnelle peut faire tourner.
Projet privé, pas de lien public